各 GPU 上的计算效率总表:从 RTX 4090 到 H100
官方测试条件
官方在 GitHub 发布的 GPU 效率数据,测试条件统一如下:
| 配置 | 说明 |
|---|---|
| 多卡 14B 模型 | --ulysses_size 4/8 --dit_fsdp --t5_fsdp |
| 多卡 5B 模型 | --ulysses_size 4/8 --offload True --convert_dtype --t5_cpu |
| 单卡 14B | --offload True --convert_dtype |
| 单卡 5B | --offload True --convert_dtype --t5_cpu |
| FlashAttention | Hopper 架构用 FlashAttention 3 |
| Prompt 扩展 | 测试时关闭(不额外计时) |
| 预热 | 多次采样后取平均值 |
效率图
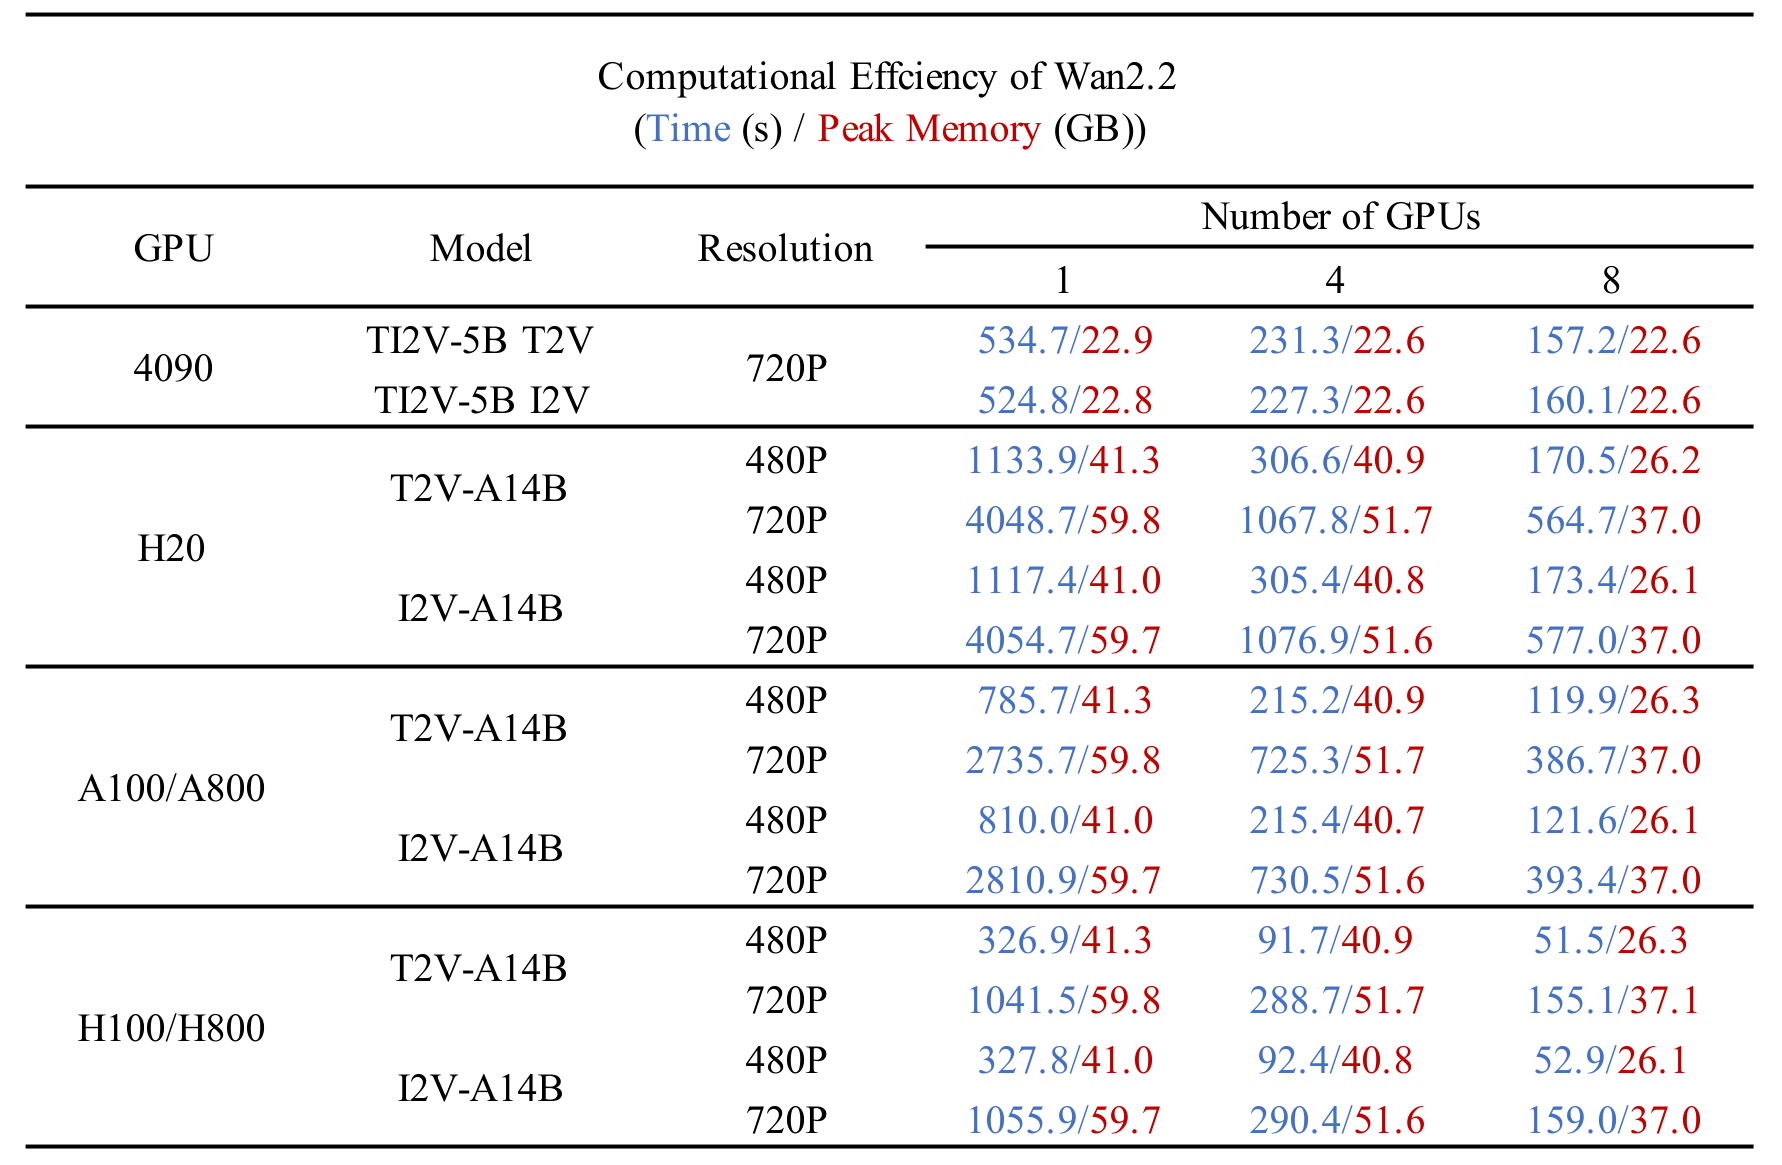
怎么读这张图
每个格子里有两个数字:
- 前一个数字:生成一段视频的总时间(秒)
- 后一个数字:峰值 GPU 显存占用(GB)
例如 120 / 22 表示总耗时 120 秒、峰值显存 22GB。行是模型,列是 GPU。
关键发现
- TI2V-5B 在 RTX 4090 上:约 9 分钟生成 5 秒 720P 视频,显存约 22GB——这是消费级显卡唯一可跑的配置
- A14B 在 A100 80GB 单卡上:约 10~15 分钟(取决于分辨率),显存约 60~80GB,需要 offload
- 8 卡 H100 + Ulysses:速度约为单卡的 5~7 倍,是目前最快的本地配置
- FlashAttention 3(Hopper 专属):比 FlashAttention 2 快约 30~50%
实际部署建议
| 你的硬件 | 推荐模型 | 备注 |
|---|---|---|
| 24GB 以下(4090/3090) | TI2V-5B | 唯一能跑的 |
| 80GB 单卡(A100/H100) | 全部模型(开 offload) | 速度较慢但能跑 |
| 多卡 A100/H100 | 全部模型(FSDP+Ulysses) | 生产级速度 |
| 无 GPU | 百炼 DashScope API | 付费按秒计费 |