MoE 验证损失对比:为什么双专家比单专家好
四组对比设置
为了验证 MoE 架构的有效性,Wan2.2 团队做了四组对比,都看验证损失(Validation Loss)——损失越低,说明生成视频的分布越接近真实视频:
| 模型 | 高噪专家 | 低噪专家 | 验证损失 |
|---|---|---|---|
| Wan2.1(基线) | 无(单专家) | 无(单专家) | 较高 |
| Wan2.1 + Wan2.2 高噪专家 | Wan2.2 新训练 | 复用 Wan2.1 | 较高 |
| Wan2.2 高噪专家 + Wan2.1 | 复用 Wan2.1 | Wan2.2 新训练 | 较高 |
| Wan2.2 完整 MoE | Wan2.2 新训练 | Wan2.2 新训练 | 最低 |
关键结论
- 两个专家必须联合训练——把 Wan2.1 权重拿来当某一个专家用,效果显著差于完整的 Wan2.2 MoE
- 每个专家各自解决一个阶段的问题——高噪专家负责整体布局,低噪专家负责细节优化,分工明确
- 总参数翻倍但计算量不变——这是 MoE 的核心优势:27B 总参数,每步只激活 14B
训练数据的贡献
除了架构创新,Wan2.2 的训练数据也比 2.1 大幅扩充:
- 图像 +65.6%
- 视频 +83.2%
数据 + 架构两个因素一起,才让 2.2 相对于 2.1 有了质的飞跃。单独换数据或单独换架构都做不到同样的效果。
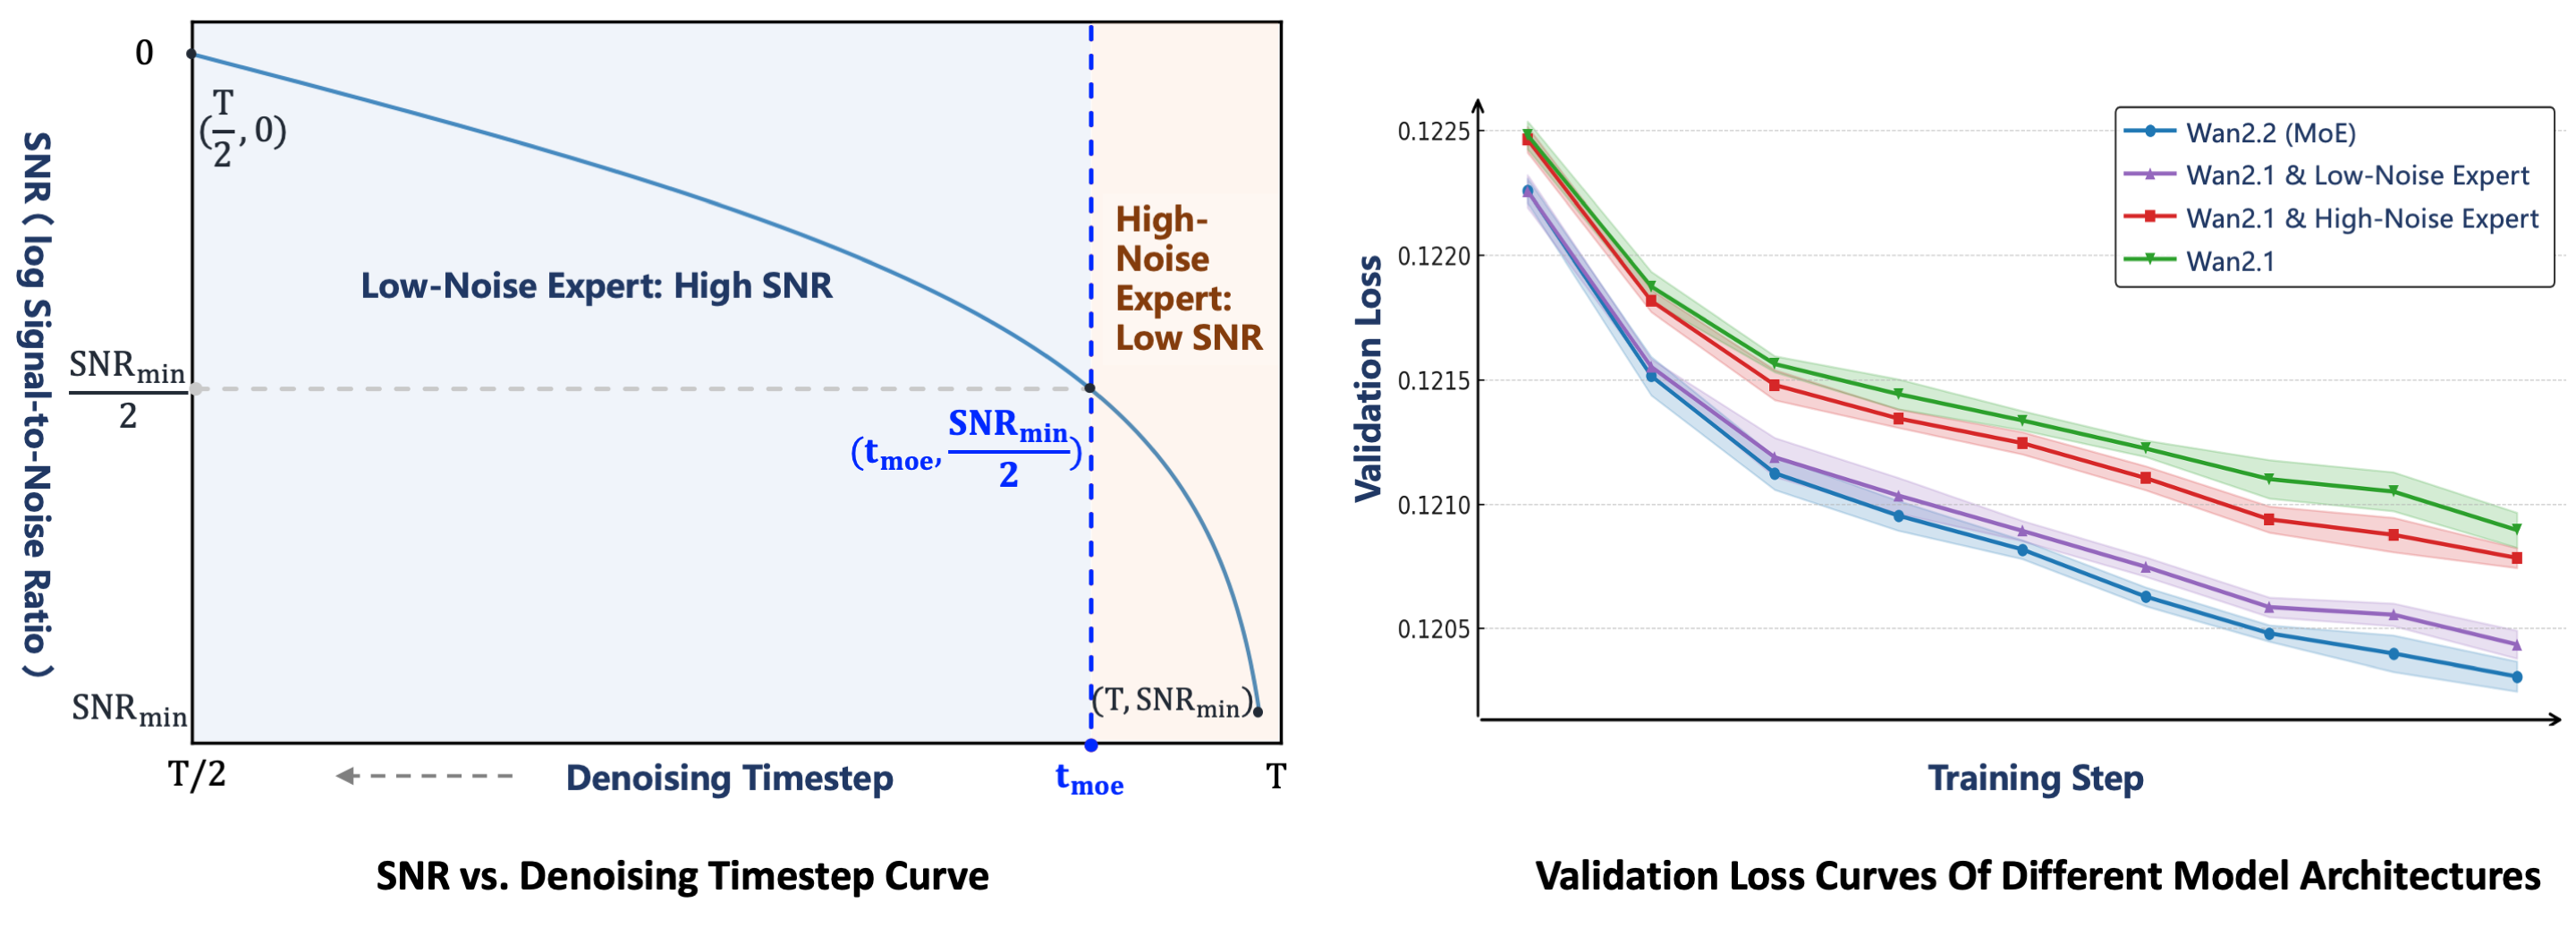
损失曲线的意义
验证损失反映的是"模型生成的视频和真实视频之间的分布距离"。损失越低,说明模型生成出来的东西越像真实世界的视频。完整 MoE 版本的损失最低,说明它在真实分布的拟合上做得最好——这就是为什么它在 Wan-Bench 2.0 上表现最好。