MoE 混合专家架构:视频扩散模型里的两个专家是怎么分工的
为什么视频模型需要 MoE
混合专家(Mixture-of-Experts, MoE)在大语言模型里已经被广泛验证——它能让模型总参数量远大于推理时实际激活的参数,从而在几乎不增加计算成本的前提下获得更强的模型容量。
Wan2.2 的创新在于:把 MoE 引入了视频扩散模型。扩散模型的去噪过程天然分成两个阶段——早期去噪关注整体布局,后期去噪关注细节优化。Wan2.2 正好用两个专家分别负责这两个阶段。
双专家设计
A14B 系列模型(T2V-A14B 和 I2V-A14B)采用双专家设计:
- 高噪专家(High-Noise Expert):在去噪步数较大(噪声水平较高)的早期阶段激活,负责视频的整体布局生成
- 低噪专家(Low-Noise Expert):在去噪步数较小(噪声水平较低)的后期阶段激活,负责细节优化
每个专家模型约 140 亿参数,总参数量达到 270 亿,但每一步推理只激活 140 亿,因此 GPU 显存需求几乎和单专家持平。
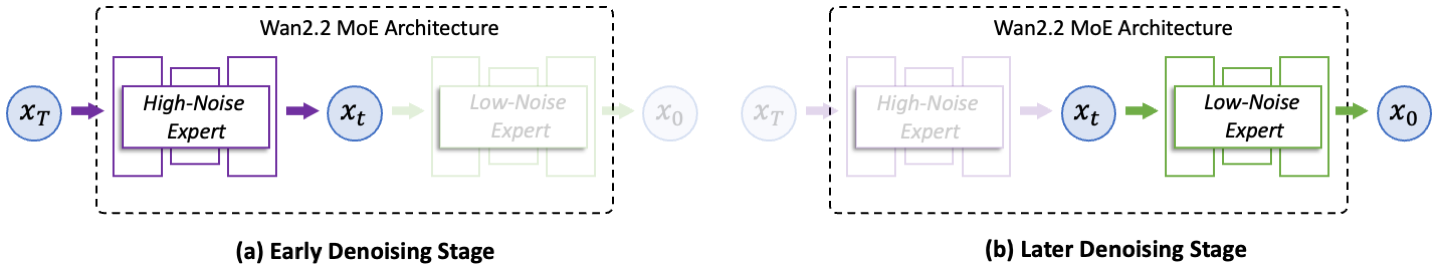
切换点由信噪比(SNR)决定
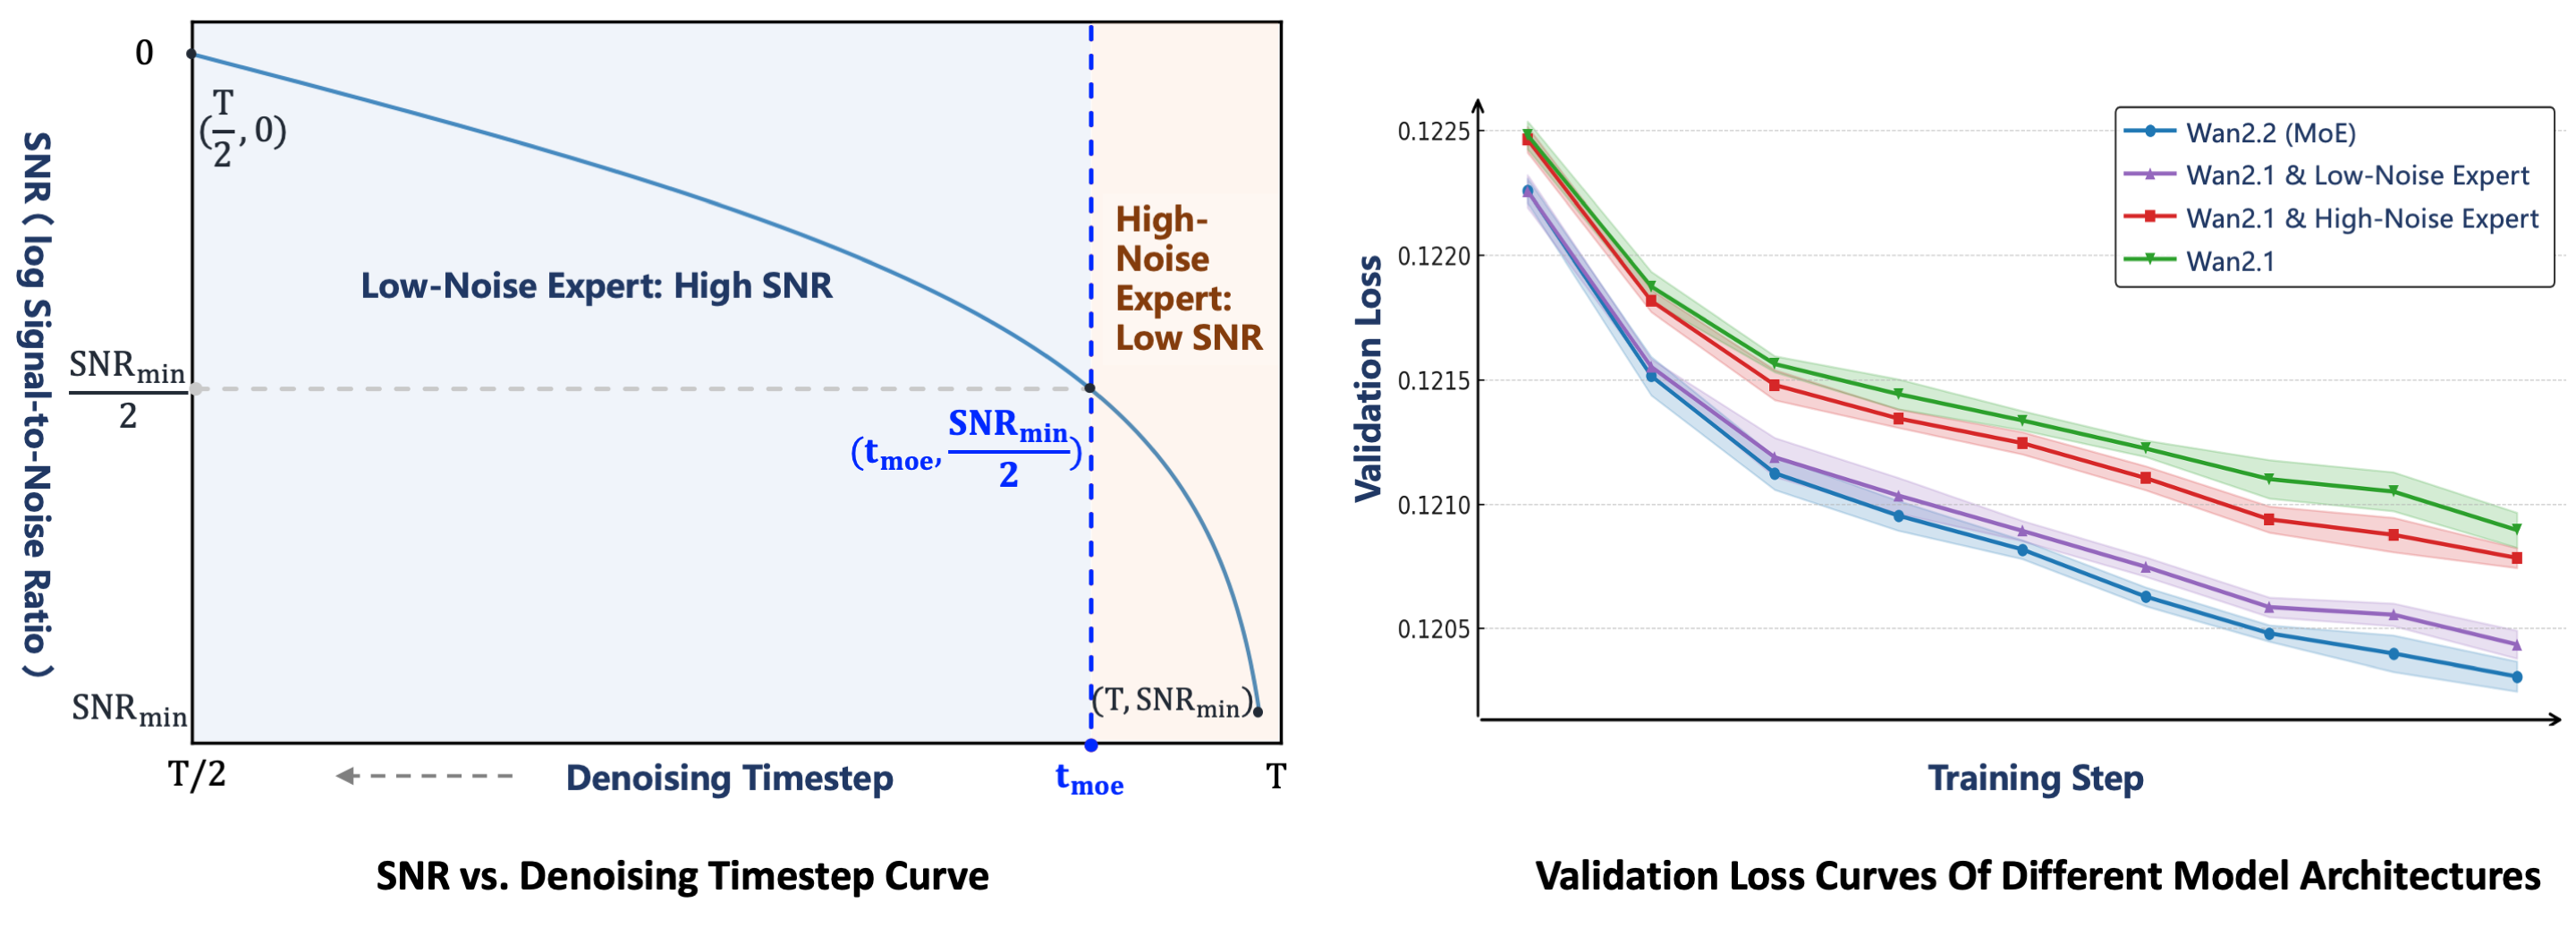
两位专家的切换点不是拍脑袋定的,而是由信噪比(SNR, Signal-to-Noise Ratio) 决定。SNR 随着去噪步数 t 的增加而单调下降:
- 去噪开始时,t 很大,噪声水平高,SNR 处于最小值 → 高噪专家激活
- 当 SNR 降到最小值的一半时,模型切换到低噪专家继续去噪
切换的实际位置取决于模型内部的阈值步数 tmoe,不需要用户干预。
MoE 对训练的要求
MoE 架构并不是给 Wan2.1 换个壳就行。训练时,Wan2.2 做了四组对比实验来验证 MoE 的有效性:
- 基线 Wan2.1:单专家,无 MoE
- Wan2.1 & 高噪专家:Wan2.1 权重作低噪专家 + Wan2.2 高噪专家
- Wan2.1 & 低噪专家:Wan2.1 权重作高噪专家 + Wan2.2 低噪专家
- Wan2.2(完整 MoE):两个专家都是 Wan2.2 训练出来的
完整 MoE 版本在验证损失上最低,说明两个专家必须联合训练才能达到最好效果。
用户感知层面
对于普通用户,MoE 架构最直接的好处是:
- 推理速度不变,但生成质量(尤其是细节和运动连贯性)明显提升
- 模型权重文件会变成两份(高噪 + 低噪),部署时两个都要加载
- ComfyUI 等第三方节点也需要分别加载两个 safetensors 文件
想本地体验 MoE 架构的完整效果,参考 T2V 基础推理 的显存和硬件要求。