Wan2.2 模型家族全景:T2V I2V TI2V S2V Animate 各干什么
一个家族,五个成员
Wan2.2 是阿里通义实验室(Tongyi Lab)在 Wan2.1 基础上推出的视频生成基础模型系列。它最容易被误解的地方是——很多人以为它是一个模型,实际上它是一组五个模型,各自面向不同的视频生成任务。
所有成员在 2025 年 7 月到 11 月之间陆续开源,权重统一以 Apache 2.0 协议发布在 GitHub、HuggingFace 和 ModelScope 三个渠道。
家族一览
| 模型代号 | 完整名称 | 输入 → 输出 | 核心场景 |
|---|---|---|---|
| T2V-A14B | Wan2.2 Text-to-Video MoE | 文字描述 → 视频 | 纯创意生成,没有参考图 |
| I2V-A14B | Wan2.2 Image-to-Video MoE | 一张静态图 → 带运动视频 | 首帧约束下的动态化 |
| TI2V-5B | Wan2.2 Text-Image-to-Video | 文字 或 图片 → 720P 视频 | 消费级显卡(4090)本地跑 |
| S2V-14B | Wan2.2 Speech-to-Video | 语音 + 人像 → 对口型视频 | 数字人、直播头像、配音驱动 |
| Animate-14B | Wan2.2 Character Animation | 角色图 + 动作参考视频 → 动画视频 | 把角色放进参考动作里 |
MoE 与 稠密模型的分工
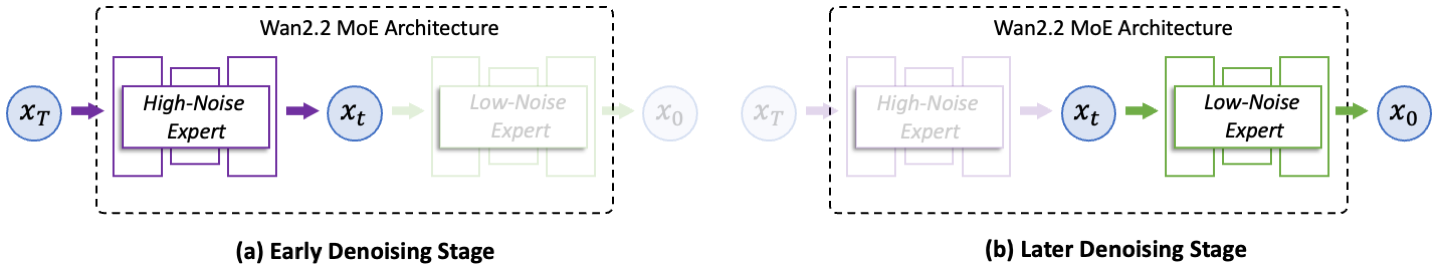
家族内部有一个关键分工:T2V / I2V 使用 MoE 架构,TI2V / S2V / Animate 使用稠密架构。
MoE 架构的好处是:总参数量可以很大(A14B 的总参数 270 亿),但推理时每一步只激活一半(140 亿),计算量和显存几乎不变。代价是需要两个专家模型文件,部署稍微复杂一点,适合云端或多卡环境。
稠密模型(TI2V-5B 等)结构更简单,只有一套权重,单卡就能跑,适合本地开发和轻量部署。
训练数据的增长
与 Wan2.1 相比,Wan2.2 的训练数据显著扩充:
- 图像数量增加 65.6%
- 视频数量增加 83.2%
这个扩充直接带来了更丰富的运动模式、更精准的语义理解和更可控的美学风格,也是 Wan2.2 在 Wan-Bench 2.0 上追平闭源模型的基础。
各成员详解入口
接下来的页面对每个模型单独拆解:
- T2V 基础推理 —— T2V-A14B 的 prompt 扩展、MoE 双专家切换点
- I2V 基础推理 —— I2V-A14B 的运镜控制与产品一致性
- 4090 本地跑 —— TI2V-5B 的压缩结构与消费级部署
- S2V 模型介绍 —— S2V-14B 的音频注入流水线
- Animate 模型介绍 —— Animate-14B 的两种模式